Abra cualquier herramienta de IA y pregúntele sobre su negocio. Responde con seguridad y se equivoca en los detalles, porque no sabe nada de usted. Ni sus precios, ni sus políticas, ni un solo cliente. Así que, su equipo vuelve a pegar los antecedentes en cada conversación, una versión un poco distinta cada vez. Esa brecha, entre lo inteligente que es la IA y lo poco que sabe de su empresa, es el techo con el que choca casi todo negocio. Una base de conocimiento de IA es la manera de subirlo: una memoria propia y estructurada de la que su IA de verdad puede sacar información, para que trabaje a partir de lo que es cierto sobre su negocio y no de una suposición nueva. Aquí está qué es, cómo funciona y por qué es la pieza que le falta a la mayoría de los negocios.
Puntos clave
Es la capa de contexto propia que su IA consulta antes de responder, y una sola base de conocimiento puede alimentar a la vez un chatbot, un asistente interno y sus automatizaciones.
En lugar de que su equipo vuelva a pegar los mismos antecedentes en cada chat, la información aprobada de la empresa se puede recuperar cuando se necesite.
El sistema encuentra los pasajes relevantes para una pregunta y se los entrega a la IA, así las respuestas se basan en sus documentos reales y citan su fuente.
Una fuente de verdad con nombre, etiquetas claras y una rutina de actualización son la diferencia entre respuestas correctas y respuestas equivocadas dichas con seguridad.
La IA solo debe recuperar lo que la persona que pregunta tiene permitido ver, sobre todo cuando hay datos de clientes de por medio.
Los documentos, la base de datos y las cuentas le pertenecen, para que nunca tenga que rentarle a un proveedor el conocimiento de su propia empresa.
El problema de la hoja en blanco, y lo que cuesta
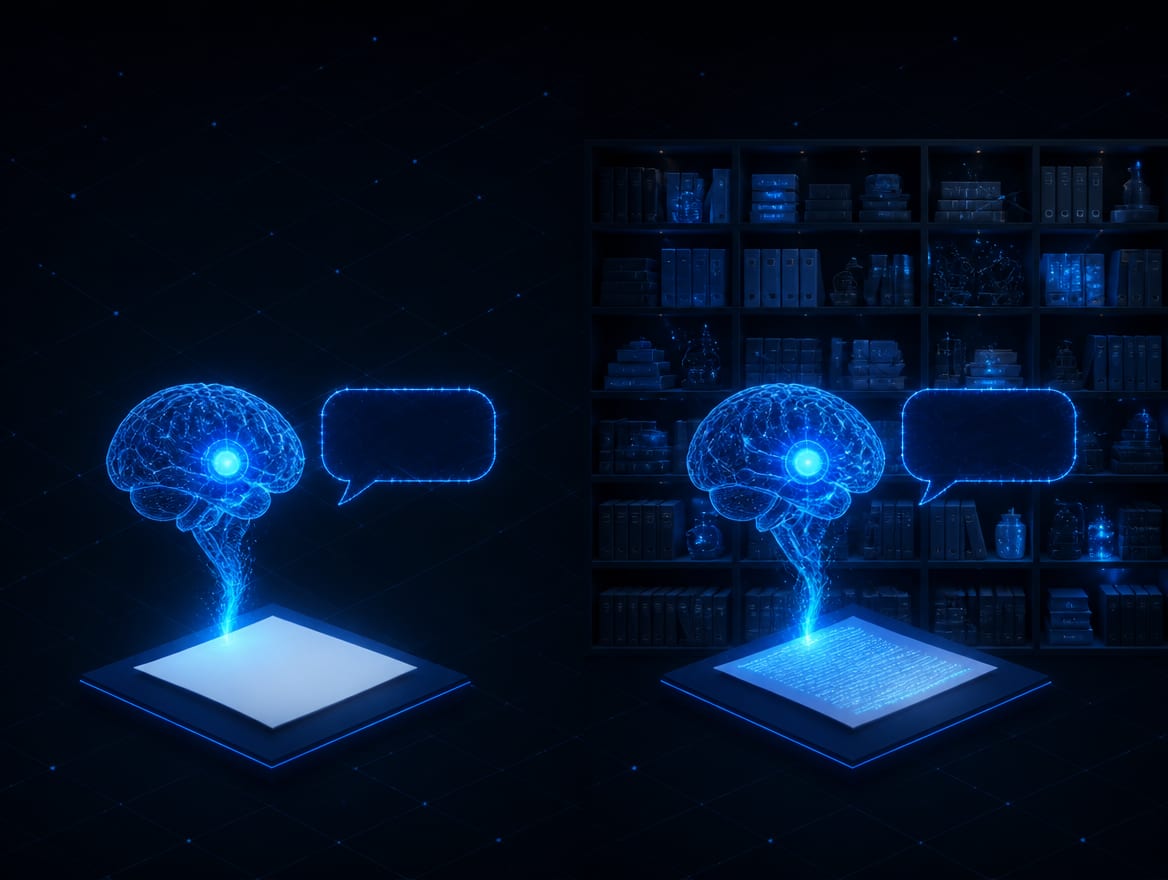
Cada conversación nueva con una IA empieza desde cero. El modelo tiene una inteligencia general enorme y ninguna memoria de su negocio, así que la carga cae en su gente. Pegan la lista de servicios, los precios actuales, la política del trimestre pasado, el historial del cliente, solo para obtener una respuesta útil. Luego el siguiente empleado lo vuelve a hacer, con una versión un poco distinta de los hechos. El resultado es trabajo lento, respuestas inconsistentes y una IA que nunca mejora en su negocio porque nunca lo recuerda.
Ese es el costo real, y es fácil pasarlo por alto porque ningún caso aislado parece caro. Diez minutos de dar contexto aquí, una respuesta equivocada allá, dos empleados contándoles a los clientes dos historias distintas. Súmelo en todo un equipo y durante un mes, y la herramienta de IA «gratuita» se está comiendo horas y desgastando la confianza. Una base de conocimiento elimina por completo el volver a explicar, porque el contexto se guarda una vez y se recupera cada vez que el trabajo lo necesita.
Entonces, ¿qué es exactamente una base de conocimiento de IA?
Una base de conocimiento de IA es un almacén persistente y estructurado de la información aprobada de su negocio, organizado para que cualquier herramienta de IA pueda sacar la pieza correcta en el momento correcto. Guarda lo que un modelo nunca podría saber por sí solo: sus servicios y precios, sus procedimientos estándar, sus preguntas frecuentes, sus políticas y, cuando la conecta, el historial de sus clientes y de sus comunicaciones.
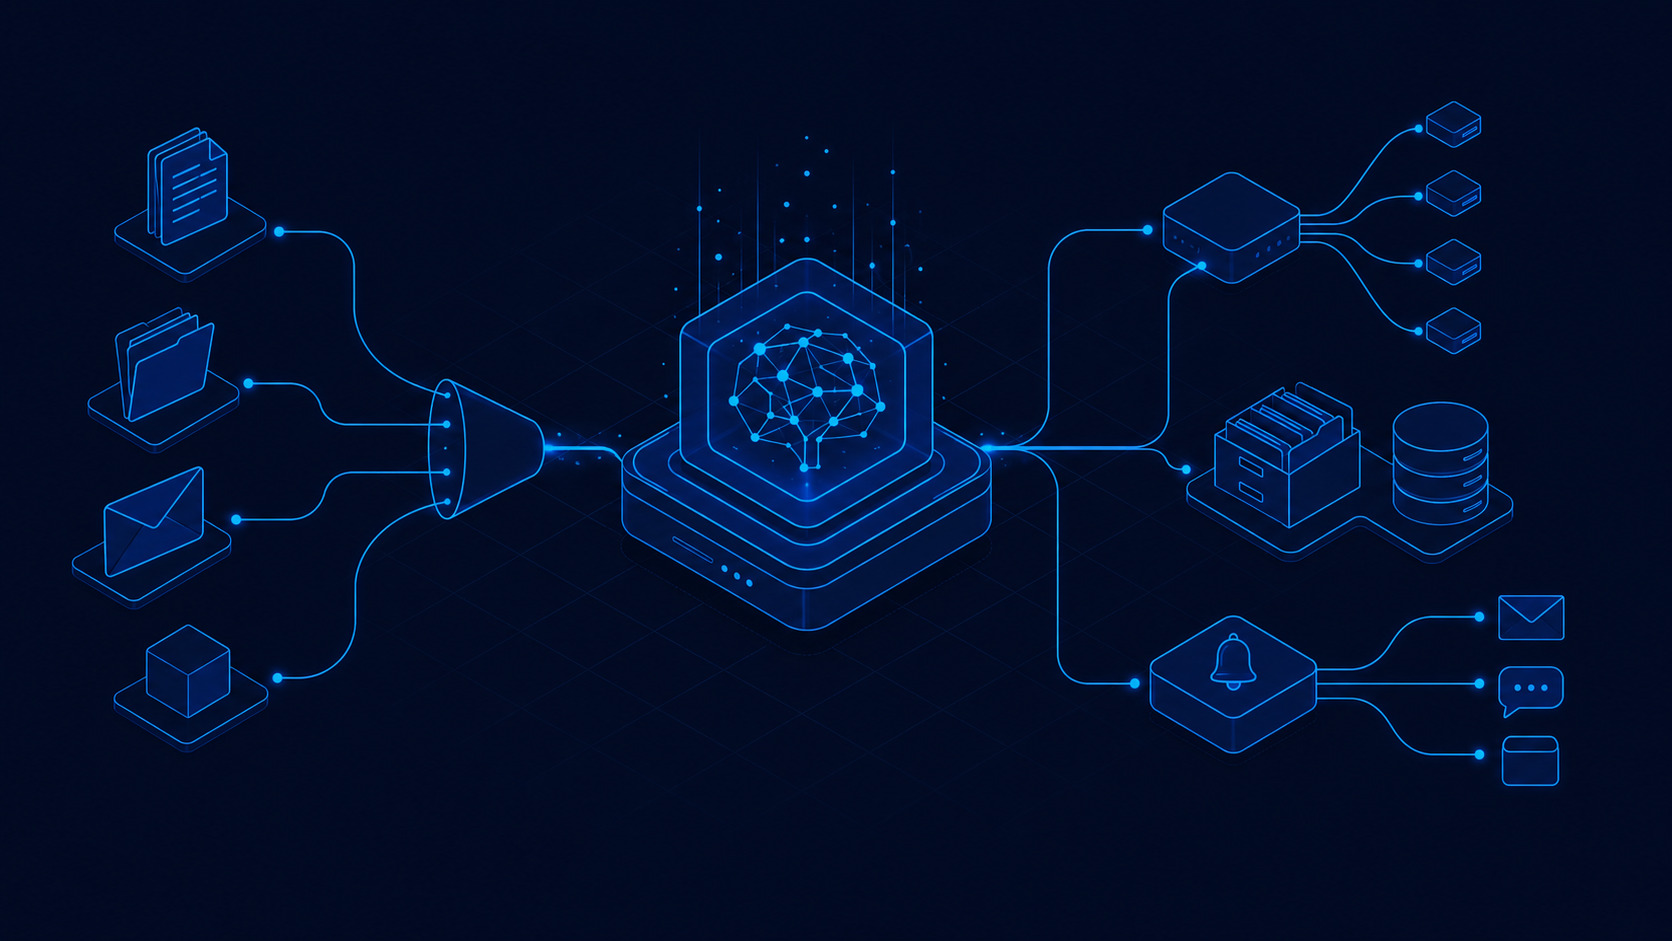
La distinción más importante es esta: una base de conocimiento no es un chatbot. Un chatbot es una interfaz, la caja donde la gente escribe. Una base de conocimiento es la capa de contexto que está debajo, la memoria que la IA consulta antes de responder. Esa diferencia importa porque una sola base de conocimiento puede dar servicio a muchas interfaces a la vez: el chatbot de su sitio web, un asistente interno al que su personal le hace preguntas y las automatizaciones que corren en segundo plano. Usted construye la memoria una vez, y todo lo que le conecta se vuelve más inteligente. Confunda las dos cosas y comprará una boca sin nada detrás.
Cómo funciona en realidad: recuperación, no un solo prompt gigante
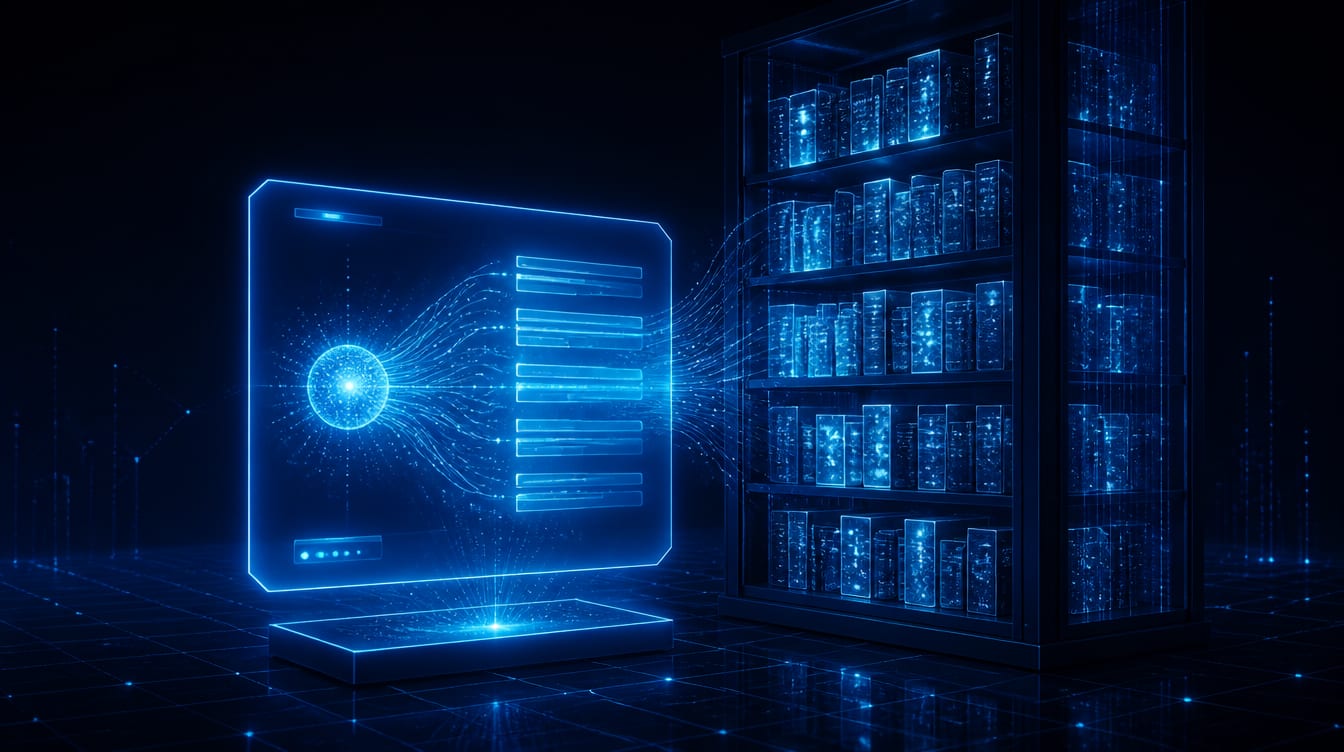
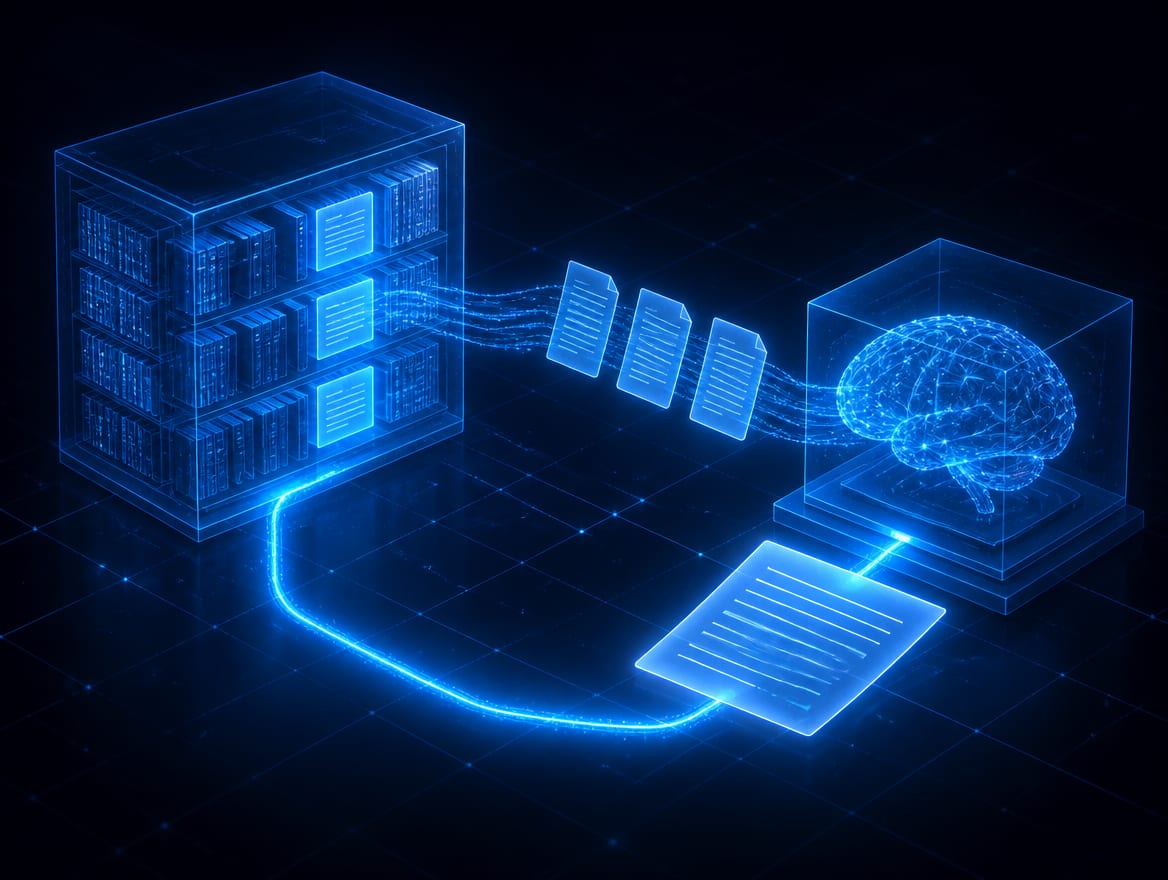
El método común detrás de una base de conocimiento se llama recuperación, o RAG (retrieval-augmented generation, generación aumentada por recuperación). En palabras sencillas: en lugar de meter toda la historia de su empresa en cada prompt, el sistema guarda su información en una forma que se puede buscar, encuentra solo los pasajes relacionados con la pregunta y se los entrega a la IA justo antes de que responda. La respuesta regresa basada en sus documentos reales, con un enlace a la fuente para que cualquiera pueda verificar de dónde salió.
Va a escuchar tres términos técnicos, y son más sencillos de lo que suenan.
RAG
El método de recuperar y luego responder que se describe arriba. La IA saca primero la información aprobada y luego responde a partir de ella, en lugar de adivinar de memoria.
Embeddings
Una manera de convertir su texto en algo que una computadora puede buscar por significado, y no solo por coincidencia de palabras exactas. Es lo que permite que una búsqueda de «reglas de reembolso» encuentre el pasaje titulado «política de devoluciones».
Base de datos vectorial
Simplemente el lugar donde se guarda esa forma que se puede buscar. Es el archivero, no la magia.
Ninguna de esas palabras demuestra que un sistema sea bueno. Lo que lo demuestra es si el sistema saca el pasaje correcto, lo cita y respeta quién tiene permitido verlo.
Qué se guarda en ella, y por qué la estructura decide la precisión
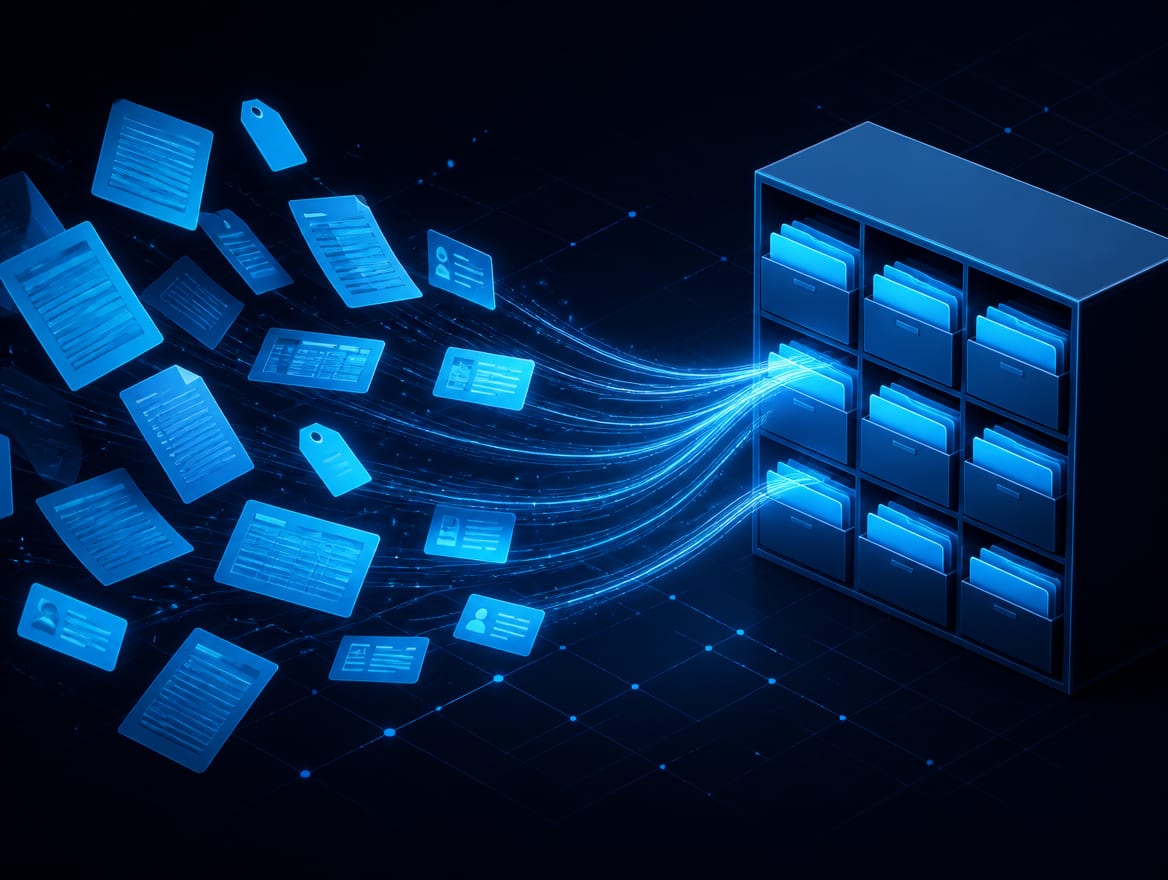
La base de conocimiento guarda todo lo que el modelo no puede adivinar: sus servicios y precios actuales, sus procedimientos, sus preguntas frecuentes, sus políticas y el historial de sus clientes cuando está conectado. Hoy eso vive disperso en documentos, carpetas y la memoria de la única persona que «simplemente lo sabe». En un solo lugar, se puede recuperar en segundos.
Pero un montón de archivos no es una memoria, y aquí es donde fracasan la mayoría de los intentos. Echar todos los documentos en una herramienta y esperar que la IA los ordene produce respuestas equivocadas dichas con seguridad. La precisión viene de la instalación de fondo: una fuente de verdad con nombre para que la IA nunca cite el precio del año pasado como si fuera el actual, etiquetas y estructura claras para que la recuperación encuentre el pasaje correcto, un enlace al original para que una persona pueda verificar con un clic, y una rutina de actualización porque los precios y las políticas cambian y una memoria desactualizada se vuelve un riesgo. Haga ese trabajo y la IA deja de adivinar. Sáltelo y tendrá una manera cara de equivocarse más rápido.
Permisos: una sola memoria, no una puerta abierta
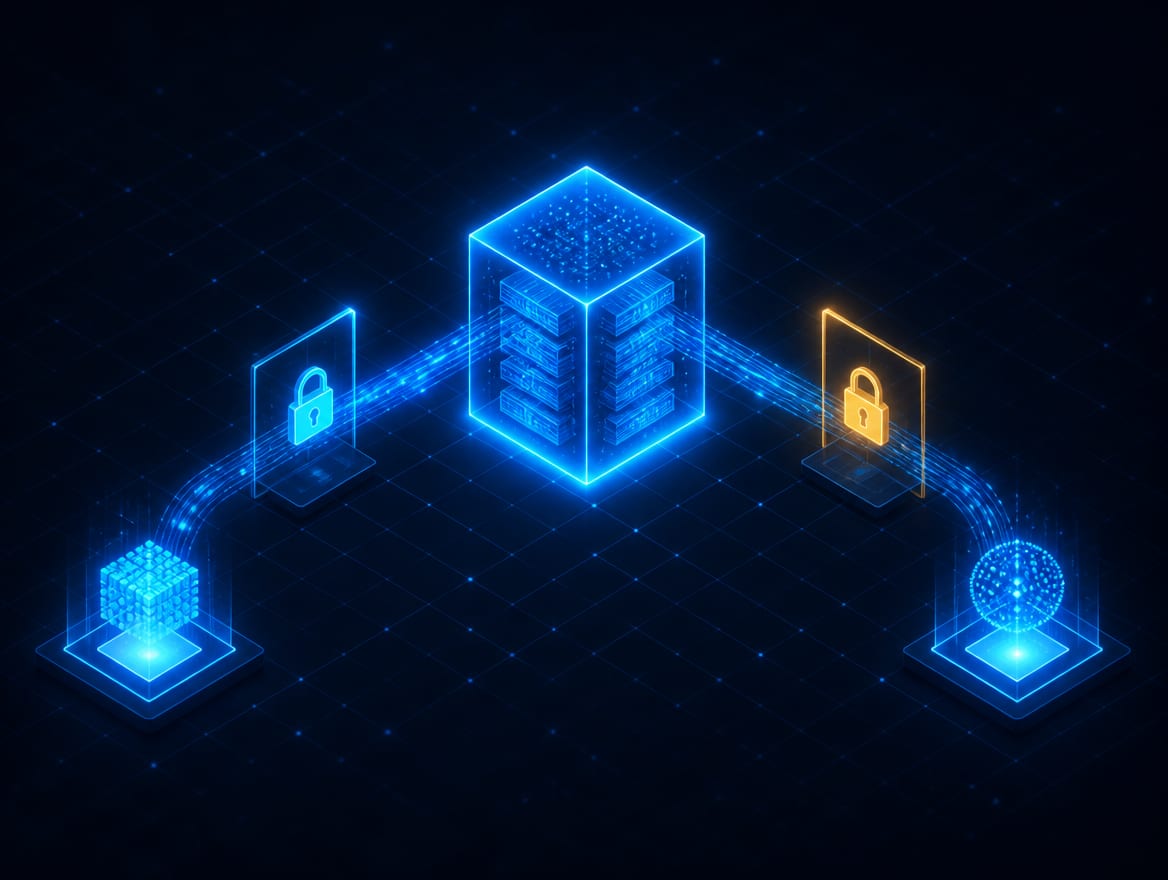
En cuanto el historial de clientes, los precios o los mensajes privados entran en una base de conocimiento, «quién puede recuperar esto» se vuelve lo más importante. Una construcción seria trata la base de conocimiento como algo que respeta permisos, no como un depósito abierto donde cualquiera con acceso puede sacar cualquier cosa. La recuperación respeta a la persona que pregunta, así que una recepcionista y un dueño no reciben las mismas respuestas a la misma pregunta.
Eso significa decidir la gobernanza antes de cargar cualquier cosa: qué datos se permiten, quién puede recuperar cada tipo, dónde se guardan y quién puede borrarlos o exportarlos. Los registros de clientes quedan detrás de un acceso más estricto que una sección pública de preguntas frecuentes. Cada recuperación queda registrada. Esto es disciplina común para manejar datos de un negocio, y es justo lo que se salta una configuración de «subir archivos y rezar».
¿Chatbot, fine-tuning o base de conocimiento? Una comparación rápida
Las tres se confunden todo el tiempo, y resuelven problemas distintos. Aquí está la versión sencilla.
| Enfoque | Qué es en realidad |
|---|---|
| Base de conocimiento de IA | La capa de memoria propia: información aprobada de la empresa, recuperada y citada cuando se necesita, que alimenta cualquier herramienta de IA |
| Chatbot | Una interfaz que habla con visitantes o con el personal; funciona mejor montada sobre una base de conocimiento |
| Un solo prompt largo | Pegar el contexto en cada chat; no crece con el negocio, se desactualiza y cada persona lo escribe distinto |
| Fine-tuning de un modelo | Volver a entrenar un modelo con sus datos; caro, lento de actualizar y aun así sin citas de fuentes en vivo |
Para casi cualquier negocio, la base de conocimiento es el cimiento, y un chatbot o una automatización va encima de ella. El fine-tuning rara vez es el primer paso correcto, y quien lo propone de entrada para un problema normal de negocio por lo general le está vendiendo una complejidad que usted no necesita.
Repaso rápido: bases de conocimiento de IA
Elija una respuesta para empezar.
1. ¿Cuál es la diferencia principal entre un chatbot y una base de conocimiento?
2. ¿Por qué importa tanto la estructura en una base de conocimiento?
3. ¿Quién debe ser dueño de los datos y de la base de datos en una base de conocimiento bien construida?
Preguntas frecuentes sobre las bases de conocimiento de IA
¿Qué es una base de conocimiento de IA en palabras sencillas?
Es un almacén estructurado y propio de la información aprobada de su negocio, que las herramientas de IA pueden recuperar y usar antes de responder. Le da a su IA contexto real sobre su empresa en lugar de una hoja en blanco.
¿Es lo mismo que un chatbot?
No. Un chatbot es una interfaz donde la gente escribe. Una base de conocimiento es la memoria detrás de ella, y una sola base de conocimiento puede alimentar al mismo tiempo un chatbot, un asistente interno y sus automatizaciones.
¿Qué es RAG?
RAG, o retrieval-augmented generation (generación aumentada por recuperación), es el método que usan la mayoría de las bases de conocimiento. Recupera primero la información aprobada relevante y luego deja que la IA responda a partir de ella, con un enlace a la fuente.
¿Puede recordar el historial de los clientes?
Sí, cuando los datos de sus clientes se conectan con los permisos y controles correctos. Las reglas de acceso se construyen desde el principio, así que los registros de clientes quedan detrás de un acceso más estricto que una sección pública de preguntas frecuentes.
¿Tengo que elegir un solo modelo de IA para siempre?
No. La base de conocimiento está separada del modelo que la lee, así que puede cambiar de herramientas de IA sin reconstruir su memoria. Esa separación es intencional y es parte de no quedar amarrado.
¿Qué tan precisa es?
La precisión depende de la calidad de sus fuentes, de qué tan bien está estructurado el contenido y de las pruebas continuas, no de una sola pieza de tecnología. Una buena construcción prueba la recuperación con sus preguntas reales y es honesta en que ningún sistema es perfecto.
Reflexiones finales
Una base de conocimiento de IA es la diferencia entre una IA que adivina sobre su negocio y una que de verdad lo conoce. Es la capa de memoria propia, estructurada para que la recuperación sea precisa, con permisos para que se le pueda confiar información real, y separada de cualquier modelo para que usted nunca quede amarrado. Constrúyala una vez y cada herramienta que conecte, el chatbot, el asistente interno, la automatización, saca información de la misma fuente de verdad.
La recompensa es silenciosa pero se acumula. Su equipo deja de volver a explicar el negocio, sus respuestas dejan de variar, y el conocimiento que ha pasado años acumulando por fin se convierte en algo que su IA puede usar, en lugar de algo atrapado en archivos dispersos y en la cabeza de una persona.
En Web Leveling construimos la base de conocimiento de IA como un activo propio: sus documentos, su base de datos, sus cuentas, estructurados para una recuperación precisa y hechos para durar. Si su IA sigue empezando desde una hoja en blanco, contáctenos y le enviaremos un plan claro y realizable en un día hábil. Construya la memoria una vez; todo lo que le conecte se vuelve más inteligente.
Términos
Base de conocimiento de IA: términos clave
Toque un término para ver qué significa.
RAG. Retrieval-augmented generation, generación aumentada por recuperación. La IA recupera primero los pasajes aprobados relevantes de su base de conocimiento y luego responde a partir de ellos, en lugar de adivinar.
Embeddings. Una manera de convertir su texto en algo que una computadora puede buscar por significado, y no solo por coincidencia de palabras exactas.
Base de datos vectorial. El lugar donde vive esa forma de su contenido que se puede buscar. Es el archivero, no la magia.
Recuperación. Encontrar los pocos pasajes que de verdad se relacionan con una pregunta y entregárselos a la IA justo antes de que responda.
Fuente de verdad. El documento que el sistema trata como autorizado cuando dos fuentes no coinciden, para que la IA nunca cite un precio desactualizado como si fuera el actual.
Con permisos. Una recuperación que solo devuelve lo que la persona que pregunta tiene permitido ver, según su rol y no abierta de par en par.