IA que por fin recuerda su negocio.
Cada vez que su equipo abre ChatGPT, empieza de cero. No conoce sus servicios, sus precios, sus políticas, ni a un solo cliente. Así que alguien vuelve a pegar los mismos antecedentes, otra vez, y otra. Una base de conocimiento es el arreglo: una sola memoria propia de la que su IA sí puede beber.
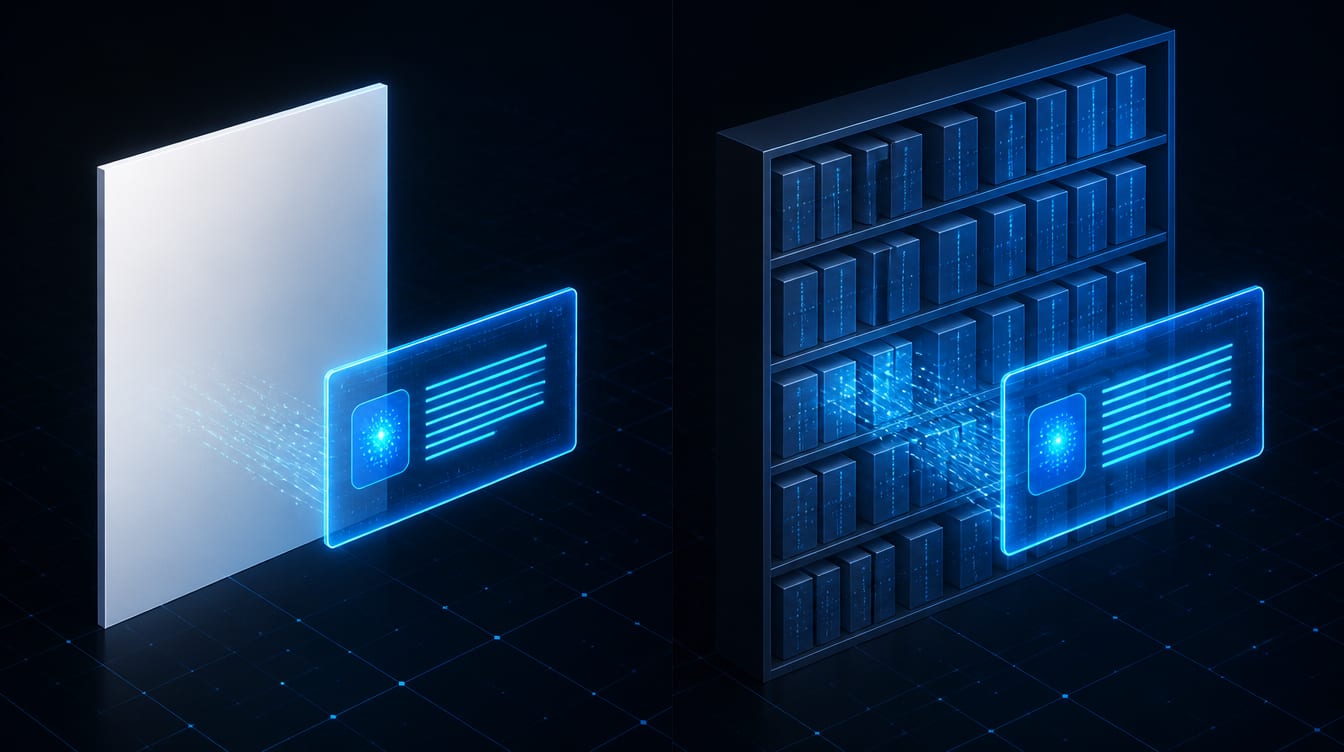
Una IA respondiendo la misma pregunta dos veces, una desde una página vacía y otra desde un estante con el conocimiento de la propia empresa detrás.
Su IA olvida su negocio. Todas las veces.
Abra un chat de IA nuevo y vea qué pasa. Es brillante, y no sabe nada de usted. Ni su lista de servicios, ni el precio de este mes, ni la política que resolvió el trimestre pasado, ni el cliente que llamó dos veces la semana pasada. Así que, su equipo hace lo único que puede: pega los antecedentes. Los servicios, las reglas, el historial, el contexto, escritos otra vez en cada conversación nueva. Diez minutos de preparación para dos minutos de respuesta, y la siguiente persona lo repite todo con una versión ligeramente distinta de la verdad.
Ese es el problema de la hoja en blanco, y es el techo silencioso de qué tan útil puede ser la IA para su negocio. El modelo tiene toda la inteligencia y nada de la memoria. No puede mejorar en su trabajo porque nunca recuerda su trabajo. Cada conversación es el día uno.
Una base de conocimiento con IA quita ese techo. Es un almacén único y propio de la información aprobada de su negocio, estructurado para que cualquier herramienta de IA pueda sacar la pieza correcta en el momento correcto. Su equipo deja de volver a explicar el negocio, las respuestas dejan de moverse, y la IA por fin trabaja desde lo que de verdad es cierto sobre su empresa en vez de una nueva adivinanza cada vez.
La capa detrás de la respuesta. No el chatbot encima de ella.
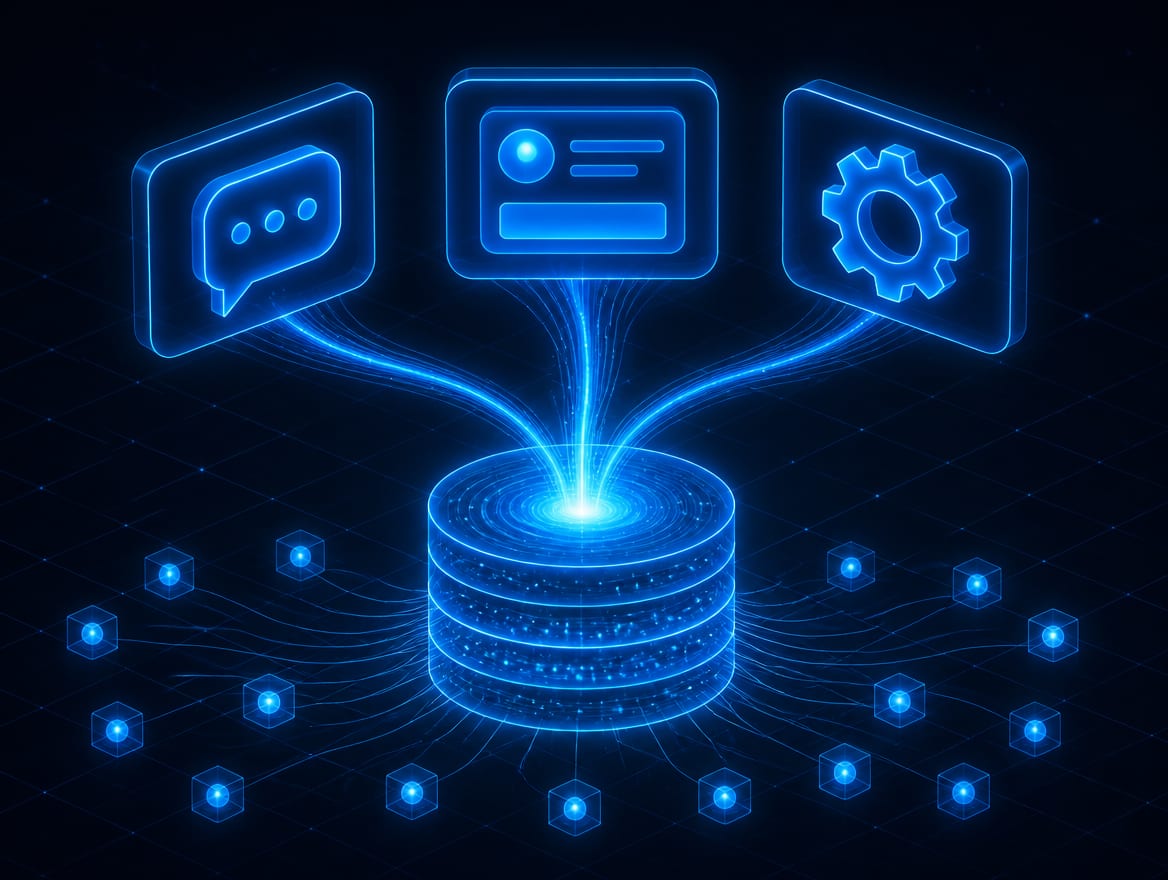
Es fácil confundir esto con un chatbot, así que seamos exactos. Un chatbot es una interfaz, la caja en la que la gente escribe. Una base de conocimiento es la capa de contexto por debajo: la información aprobada de la empresa a la que la IA se estira antes de responder. Una sola base de conocimiento puede alimentar muchas interfaces. La misma memoria puede mover el chatbot de su sitio web, un asistente interno al que su personal pregunta, y las automatizaciones que corren en segundo plano. Construye el cerebro una vez; todas las caras de encima lo comparten.
La forma común de construir esa memoria es un método llamado recuperación. En términos llanos: en lugar de meter toda la historia de su empresa en cada indicación, el sistema guarda su información en una forma buscable, encuentra solo los pasajes que de verdad se relacionan con la pregunta, y se los entrega a la IA justo antes de que responda. La respuesta regresa anclada en sus documentos reales, con un enlace de vuelta a la fuente, para que cualquiera pueda revisar de dónde salió.
Va a escuchar la jerga: RAG, incrustaciones, base de datos vectorial. Esto es todo lo que significa. RAG es ese método de recuperar y luego responder. Las incrustaciones son una forma de convertir su texto en algo que una computadora puede buscar por significado, no solo por coincidencia de palabras. Una base de datos vectorial es donde vive esa forma buscable. Ninguna de esas palabras es prueba de que el sistema sea bueno. Lo que lo hace bueno es si saca el pasaje correcto, lo cita, y respeta quién tiene permitido verlo. Para eso construimos.
“Un chatbot es una cara. La base de conocimiento es la memoria detrás de la cara. Confunda las dos y compra una boca sin nada atrás.”
Todo lo que el modelo no puede adivinar. Escrito una vez.
La base de conocimiento sostiene las cosas que la IA jamás podría saber de su negocio por su cuenta: su lista de servicios y sus precios vigentes, sus procedimientos estándar, sus preguntas frecuentes, sus políticas, y, cuando lo conecta, su historial de clientes y de comunicación. Lo que hoy vive repartido entre documentos sueltos, unas cuantas carpetas, y la memoria de la única persona que «nomás sabe». En un solo lugar, recuperable en segundos.
Pero una pila de archivos no es una memoria, y aquí es donde casi todos los intentos se caen. Vaciar todos los documentos en una herramienta y esperar que la IA los ordene le da respuestas seguras y equivocadas. Una base de conocimiento se gana su lugar en la limpieza que va por debajo:
- Una fuente de verdad nombrada. Cuando dos documentos se contradicen, el sistema necesita saber cuál gana, para que la IA nunca cite el precio del año pasado como si fuera el de hoy.
- Estructura y etiquetas. Títulos, fechas, responsables y tipos de documento claros, para que la recuperación encuentre el pasaje correcto en vez de uno parecido.
- Un camino de regreso al original. Cada respuesta enlaza al documento del que salió, para que una persona lo verifique con un clic.
- Una rutina de actualización. Los precios cambian, las políticas cambian, los procedimientos cambian. Una memoria vale lo que vale su última actualización, así que mantenerla al día es parte del diseño, no una ocurrencia tardía.
Haga este trabajo y la IA deja de adivinar. Sáltelo y tendrá una forma cara de equivocarse más rápido.
Una memoria. No una puerta abierta.
Aquí va la parte que una construcción seria se toma en serio y una descuidada ignora. En el momento en que el historial de clientes, los precios, los contratos o los mensajes privados entran a una base de conocimiento, «quién puede recuperar esto» se vuelve todo el partido. La base de conocimiento no es una sola alberca abierta donde cualquiera con acceso puede sacar cualquier cosa. La recuperación debe respetar a quien pregunta, para que un asistente de recepción y un dueño no reciban las mismas respuestas a la misma pregunta.
Eso significa gobierno real, decidido antes de cargar nada: qué datos tienen permitido entrar, quién puede recuperar cada tipo de ellos, dónde se guardan, cuánto tiempo se conservan, y quién los puede borrar o exportar. Los registros de clientes y las cifras financieras viven detrás de un acceso más estrecho que unas preguntas frecuentes públicas. Cada recuperación queda registrada. El material sensible va cifrado. Esta es disciplina ordinaria para cualquiera que maneje datos de negocio, y es exactamente la disciplina que se salta un montaje de subir archivos y rezar.
Primero la estructura. No subir y esperar.
La versión fracasada de este proyecto siempre se ve igual: alguien vacía todos los archivos en una herramienta, consigue una demostración impresionante, y después la ve citar precios vencidos e inventar políticas en el uso real. Nosotros construimos al revés, desde las fuentes hacia afuera, para que aguante un martes desordenado y no solo la demostración.
Definir las fuentes de verdad
Empezamos nombrando qué documentos mandan, cuáles están vencidos, y cuál gana cuando dos se contradicen. Este es el paso menos vistoso y el que decide si toda respuesta posterior es confiable. Casi todo el valor se fija aquí, antes de cargar nada.
Limpiar y estructurar
Preparamos el contenido como la recuperación lo necesita en realidad: títulos, secciones, fechas, responsables y etiquetas claros, con términos consistentes para sus servicios y productos. Buena estructura adentro es recuperación precisa afuera. Una fuente limpia le gana a un modelo ingenioso todas las veces.
Construir la capa de recuperación
Guardamos su información en una forma buscable, conectamos el flujo de recuperar y luego responder, y lo dejamos listo para devolver un enlace a la fuente con cada respuesta. Aquí agregamos los permisos por rol, para que la recuperación respete a quien pregunta desde el primer día, no como un añadido posterior.
Probar con sus preguntas reales
Un sistema de recuperación que funciona con la pregunta fácil no sirve de nada con la difícil. Probamos contra sus preguntas reales, incluidas las incómodas y las que tienen fuentes contradictorias, y lo afinamos hasta que saca el pasaje correcto y admite cuando no está seguro. «No tengo eso, pregúntele a una persona» es una característica que metemos a propósito.
Entregarla con las llaves
Recibe los documentos, la base de datos, las etiquetas y la configuración, y las cuentas, todo a su nombre, más documentación que una persona normal puede leer: qué hay adentro, cómo actualizarla, y dónde están los límites. Usted es dueño de la memoria, no de una suscripción a ella.
1
La nota honesta al pie: una base de conocimiento necesita mantenimiento. Sus precios, políticas y procedimientos se mueven, y una memoria que nunca se actualiza poco a poco se vuelve un pasivo. Se lo decimos al entrar, porque una memoria dejada sola se desactualiza en cuestión de meses.
La memoria es el activo. Y el activo es suyo.
Hay una trampa conocida en el trabajo de IA: un proveedor le construye algo ingenioso y se queda con las llaves. Los documentos, la base de datos, la configuración, las cuentas, todo del lado de ellos. Funciona de maravilla hasta el momento en que usted se quiere ir, y entonces se entera de que estaba rentando un cerebro que nunca fue suyo. Con una base de conocimiento esa trampa es especialmente cara, porque la memoria es el valor. Pierda el acceso a ella y pierde los años de contexto que pagó por reunir.
Así que, construimos para la puerta de salida, a propósito. Usted posee los documentos, la base de datos, las etiquetas y las cuentas. El conocimiento que cargó es suyo, exportable, y portátil a otro proveedor o a otro modelo de IA si algún día decide moverse. Nada de la memoria depende de quedarse con nosotros, ni de quedarse con un solo proveedor de modelos. Ese es el punto de que sea suya.
“Si no puede llevarse la memoria e irse, no es suya. Está rentándole a alguien más el conocimiento de su propia empresa.”
Nada de eso significa que no haya compromiso. El trabajo real corre sobre términos reales: una cuota de arranque, un alcance claro, y un plan para el mantenimiento que una memoria viva de verdad necesita. Lo que nunca va a firmar es un amarre. Términos claros por delante, y todo, sobre todo la memoria misma, suyo al final.
Ready when you are. Your work, actually yours.
Tell us about your business and what this needs to cause. You'll have a plan back within one business day, including when the answer is that you do not need this.
Tell us your caseLos documentos, la base de datos y las cuentas pasando a manos del dueño, sin nada retenido del lado del proveedor.
Preguntadas y respondidas, antes de la llamada.
¿Esto es nada más un chatbot?
No. Un chatbot es una interfaz en la que la gente escribe. Una base de conocimiento es la memoria propia detrás de él, y una sola base de conocimiento puede alimentar un chatbot, un asistente interno y sus automatizaciones al mismo tiempo. Si lo que quiere específicamente es un asistente de sitio web, ese es nuestro servicio de chatbots, y funciona mejor montado sobre una base de conocimiento como esta.
Pregúntenos por Base de conocimiento con IA¿Puede recordar el historial de nuestros clientes?
Sí, cuando sus datos de clientes se conectan con los permisos y controles correctos. Por eso exactamente las reglas de acceso y el gobierno van integrados desde el arranque, no agregados después. Los registros de clientes viven detrás de un acceso más estrecho que unas preguntas frecuentes públicas.
Hablemos de Base de conocimiento con IA¿No basta con una indicación larga?
Para un conjunto pequeño y fijo de hechos, a veces. Pero las indicaciones no escalan, se vuelven caras, se desactualizan, y cada persona escribe una un poco distinta. Una capa de recuperación mantiene una sola fuente vigente de la que todos beben, y cita de dónde salió cada respuesta.
Cuéntenos su caso de Base de conocimiento con IA¿Quién es dueño de los datos y de la base de datos?
Usted, y queda escrito en el acuerdo. Los documentos, la base de datos, la configuración y las cuentas están registrados a su nombre y son exportables. Un sistema propiedad del cliente es todo el punto.
Pida un plan de Base de conocimiento con IA¿Las respuestas van a citar su fuente?
Sí. Cada respuesta debe enlazar de vuelta al documento del que salió, para que una persona lo verifique con un clic. Una base de conocimiento con IA que no puede mostrar su fuente es una a la que no le puede confiar decisiones reales.
Vea qué implica Base de conocimiento con IA¿Qué tan precisa es?
La precisión depende de la calidad de sus fuentes, de qué tan bien esté estructurado el contenido, y de las pruebas continuas, no de una sola pieza de tecnología. Probamos la recuperación contra sus preguntas reales y la afinamos, y la construimos para que diga «no estoy seguro» en vez de adivinar. Las respuestas perfectas no las ofrece ningún sistema que lea sus documentos.
Empecemos con Base de conocimiento con IA¿Necesita mantenimiento?
Sí. Los precios, las políticas, los procedimientos y los permisos cambian, y la memoria tiene que cambiar con ellos. Montamos la rutina de actualización y somos francos sobre el mantenimiento desde el principio.
Resolvamos su duda sobre Base de conocimiento con IA¿Tenemos que escoger un modelo de IA para siempre?
No. La base de conocimiento está separada del modelo que la lee, así que puede cambiar de herramienta de IA sin reconstruir su memoria. Esa separación es deliberada, y es parte de no quedar amarrado.
Pregúntenos por Base de conocimiento con IACuéntenos qué antecedentes sigue pegando su equipo en cada chat de IA, o cuál es la pregunta que tres personas distintas contestan de tres formas distintas. Mapeamos dónde vive su conocimiento en realidad, le decimos qué hace falta para volverlo una memoria que su IA pueda usar, y le respondemos en un día hábil. Construya la memoria una vez; todo lo que conecte a ella se vuelve más listo.